Query Fan-out: Deine Kunden stellen eine Frage – ChatGPT sucht nach 82 anderen
4. September 2026 · 10 Min. Lesezeit
Wenn Du ChatGPT eine Frage stellst, sucht ChatGPT nicht nach Deiner Frage. Es schreibt sich eine eigene Liste von Suchanfragen – bei einer einfachen Frage eine einzige, bei einer komplexen in meinem Test 82. Diese Liste heißt Query Fan-out, und Du kannst sie lesen. Wer weiß, wonach die Maschine sucht, schreibt für die richtige Frage.
Ich habe ein Hotel auf Bornholm gesucht
Annahme
„ChatGPT googelt meine Frage und fasst die Treffer zusammen.“
Nein. Im Sommer habe ich ChatGPT gefragt: „Ich suche auf der Insel Bornholm ein hochwertiges, nachhaltiges Hotel.“ Im Hintergrund gesucht hat ChatGPT das:
- 01Bornholm sustainable hotel
- 02luxury eco hotel Bornholm
- 03Bornholm Green Key
- 04Bornholm boutique hotel
Ich habe auf Deutsch gefragt, gesucht wurde auf Englisch. Und „Green Key“ – ein Nachhaltigkeitssiegel für Hotels – stand nicht in meiner Frage. Das Modell kannte es. Die Suchanfragen entstehen aus dem, was das Modell bereits weiß: aus seinen Trainingsdaten und aus dem Suchindex, den OpenAI selbst pflegt. Wer in diesem Wissen nicht vorkommt, kommt auch in der Suche nicht vor.
Vorher
So tippt ein Mensch: „nachhaltiges Hotel Bornholm“
Nachher
So sucht die Maschine, ebenfalls aus dem Bornholm-Gespräch: „Bornholm hotel sustainability local organic food design“
Selbsttest: Mit welchen Wörtern würde die Maschine nach der Frage Deiner Kunden suchen – und kämst Du darin vor?
Was ein Query Fan-out ist
Ein Query Fan-out ist die Liste von Suchanfragen, die ein AI-System aus Deiner Frage ableitet, bevor es antwortet. „Fan-out“ heißt Auffächern: Aus einer Frage wird ein Fächer von Suchanfragen – ich nenne ihn hier den Suchzettel der Maschine. Google beschreibt die Technik für seinen AI Mode, die Chat-Variante der Google-Suche, so:
„Eine Reihe gleichzeitiger, verwandter Suchanfragen, die das Modell erzeugt, um zusätzliche relevante Suchergebnisse für die Frage des Nutzers zu beschaffen.“
Ein Unterschied ist wichtig: Google sucht „gleichzeitig“. ChatGPT sucht in Runden – erst breit, dann mit jedem Ergebnis enger. Bei ChatGPT ist der Fächer eine Treppe, und Deine Website konkurriert um jede Stufe.
Wie so eine Treppe aussieht, zeigt eine andere Testfrage, diesmal eine schwere: HubSpot, Pipedrive und Zoho CRM für ein 8-köpfiges Vertriebsteam vergleichen – Preise, EU-Hosting, Gratisversion, Anbindung an Microsoft 365. Auf Deutsch gestellt, an das „denkende“ Modell von ChatGPT 5.6 – die Variante, die vor der Antwort länger überlegt und im Modellmenü „Thinking“ heißt. Die andere nenne ich hier das schnelle Modell. Neun Suchrunden, 45 Suchanfragen, drei Runden davon hier:
Warum das mehr ist als eine technische Randnotiz
Wer für diese Suchanfragen gefunden wird, hat deutlich bessere Chancen, zitiert zu werden. Der Beleg dafür kommt aus Googles Welt: Googles AI Overviews – die KI-Antwort über den Suchergebnissen – arbeiten laut Google mit derselben Technik wie der AI Mode, nur kannst Du den Suchzettel dort nicht lesen. Surfer, Anbieter einer SEO-Software, hat 10.000 Suchbegriffe und 173.902 URLs ausgewertet: Seiten, die für die Fan-out-Suchanfragen gefunden werden, landen mit 161 % höherer Wahrscheinlichkeit in Googles AI-Antworten als Seiten, die nur für die sichtbare Hauptfrage vorne stehen.
Zitierwahrscheinlichkeit bei Treffern für Fan-out-Suchanfragen (Surfer)
Selbsttest: Für welche Unterfragen Deines Themas wäre Deine Seite zu finden – oder nur für das eine Keyword?
So liest Du den Suchzettel selbst
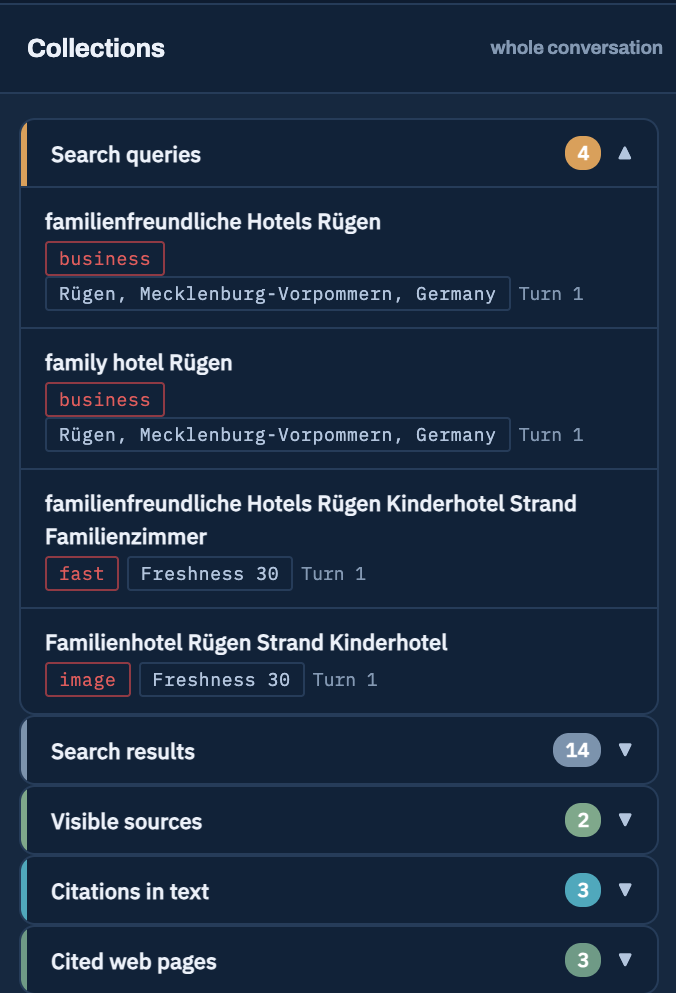
Bei ChatGPT liegt die Liste in den Rohdaten des Gesprächs, die Dein Browser beim Laden des Chats ohnehin mitbekommt. Du kannst sie von Hand herausfischen (Anleitung unten) oder ein Werkzeug lesen lassen: Das kostenlose GPTSpy von Alin Radulescu ist ein BookmarkletEin Lesezeichen, das statt einer Adresse ein kleines Script enthält. Ein Klick darauf führt das Script auf der gerade geöffneten Seite aus., das diese Rohdaten ausliest und Suchanfragen, Treffer und Zitate als Liste zeigt. Als Lesezeichen anlegen, im Chat anklicken – fertig.
Annahme
„Wenn diese Anleitung nicht mehr funktioniert, hat OpenAI die Daten abgeschaltet.“
Meist nicht. OpenAI baut die Struktur dieser Daten mit fast jeder Modellversion um. Im Frühjahr 2026 meldeten mehrere Blogs, die Suchanfragen seien „verschwunden“ – sie waren nur umgezogen. Jede Anleitung im Netz ist deshalb ein Foto, keine Landkarte. Auch diese. Läuft Schritt 2 ins Leere, suche nach queries.
Selbsttest: Lies den Suchzettel – mit GPTSpy oder der Anleitung oben – für die Frage, mit der Deine Kunden Dich finden sollten. Steht Deine Marke drauf?
Was auf dem Suchzettel steht – und was das über Dich verrät
Ich habe das an sechs Gesprächen durchgespielt: drei Fragen, jede einmal mit dem schnellen und einmal mit dem denkenden Modell von ChatGPT 5.6. Die einfache Frage nenne ich hier die Rügen-Frage: ein Familienhotel auf Rügen. Die zwei komplexen: der CRM-Vergleich von oben und die Herbstferien-Frage – ein Hotel auf Rügen für die Herbstferien, Familie mit zwei Kindern, Preis, Strandnähe, Kinderbetreuung, Stornobedingungen. Die Frage bestimmt die Breite, das Modell die Tiefe: Für die einfache Frage suchten beide Modelle genau einmal, für die komplexen das schnelle 20- bis 25-mal, das denkende 45- bis 82-mal. Die 82 gehörten zur Herbstferien-Frage. Die Tabelle zeigt den CRM-Vergleich:
| Einfache Frage | Komplexe Frage | ||
|---|---|---|---|
| schnelles Modell | denkendes Modell | ||
| Suchanfragen | 1 | 25 | 45 |
| Suchrunden | 1 | 4 | 9 |
| Auf eine Website eingegrenzt (site:) | 0 % | 88 % | 89 % |
| Treffer aus allen Suchrunden | 10 | 131 | 308 |
| Am Ende zitierte Websites | 2 | 7 | 8 |
| Denkzeit | 5 Sekunden | 11 Sekunden | 1:35 Minuten |
Drei Beispiele aus dem denkenden Modell:
- 01site:pipedrive.com data hosting EU GDPR Pipedrive data center Europe
- 02site:knowledge.hubspot.com "Microsoft 365" HubSpot Outlook calendar integration free
- 03"Zoho CRM" "14 €/Benutzer/Monat" 2026
1. Marken, die die Maschine kennt – auf deren eigenen Seiten
Fast neun von zehn CRM-Suchanfragen – bei beiden Modellen – beginnen mit site:zoho.com, site:hubspot.com oder site:support.pipedrive.com – sie suchen nur auf dieser einen Website. ChatGPT fragt nicht „welches CRM“, es fragt die drei Anbieter, die es kennt, direkt auf ihren Preis-, Hilfe- und Datenschutzseiten. Bei der Rügen-Frage kamen die drei empfohlenen Hotels nicht einmal aus der Websuche, sondern aus einem Orts-Verzeichnis mit Adresse und Koordinaten. Wer nicht als Marke oder Ort im Modell verankert ist, wird nicht gesucht.
2. B2B wird englisch gesucht, Lokales deutsch
Die CRM-Frage war deutsch, neun von zehn Suchanfragen englisch. Die Herbstferien-Frage war deutsch, die Suchanfragen fast alle auch. Das Modell sucht in der Sprache, in der es das meiste über das Thema weiß – bei Software ist das Englisch.
3. Die Maschine prüft Zahlen nach – exakt
Sobald ChatGPT einen Preis gefunden hat, sucht es den exakten Betrag noch einmal, in Anführungszeichen: „14 €/Benutzer/Monat“, „524,50“. Bei der Herbstferien-Frage mit dem denkenden Modell enthielten 59 von 82 Suchanfragen solche exakten Textstücke. Ein Preis als Text auf Deiner Seite wird in dieser Prüfrunde gefunden. Ein Preis, der nur in einer Grafik steht, nicht – OpenAIs Such-Programm liest den Text der Seite, nicht das Bild. Die Bildbeschreibung im Code (der Alt-Text) kann helfen, dann pflegst Du den Preis aber bei jeder Änderung an zwei Stellen. Sicherer ist der Preis als sichtbarer Text.
4. Die Suche ist persönlich
Bei der Herbstferien-Frage lautete die allererste Suchanfrage „Berlin Herbstferien 2026 Termine“. Von Berlin stand nichts in meiner Frage. Das Modell wusste aus früheren Gesprächen oder meinem Profil, dass ich dort wohne, suchte die Berliner Ferientermine und stellte alle Preisanfragen auf diese Woche ab. Zwei Menschen, dieselbe Frage, zwei verschiedene Suchen.
In einem Satz: Die Maschine sucht Marken, die sie kennt, auf deren eigenen Seiten, in der Sprache der Branche, mit exakten Zahlen – und für jeden Nutzer ein bisschen anders.
Was die Maschine von Deiner Seite zuerst sieht
Annahme
„Die Meta-Description entscheidet, ob ChatGPT meine Seite liest.“
Nein. Aus 308 Treffern hat ChatGPT im CRM-Gespräch mit dem denkenden Modell 8 Websites zitiert. Niemand liest 308 Seiten. Die Vorauswahl läuft – so lese ich die Rohdaten – über das, was OpenAIs Suchmaschine zu jeder Seite gespeichert hat: den Seitentitel und etwa 200 Zeichen Text. Nicht die Meta-Description, sondern der Anfang der Seite, so wie OpenAIs Such-Programm sie gesehen hat – inklusive Menüresten. Bei einem Hotelportal, gekürzt: „HOTELS FÜR FAMILIEN IN BINZ AUF RÜGEN – Teilen – Sortiert nach: [Button: Bestseller] [Button: Preis] …“. Mehr sah die Maschine nicht. Die Konsequenz ist dieselbe wie in Regel 1 für zitierbare Texte: Die Antwort steht am Anfang.
Selbsttest: Kopiere die ersten 200 Zeichen sichtbaren Text Deiner wichtigsten Seite. Würdest Du allein deshalb weiterlesen?
Was sich gerade ändert
Der Suchzettel wird länger. Der SEO-Experte Chris Long von Nectiv hat dieselben Fragen über ein Jahr verglichen, zusammengetragen von der SEO-Expertin Lily Ray: Die Zahl der Suchanfragen pro Frage stieg im Schnitt von 2,17 auf 7,61. Der wichtigste Grund ist das Modell: Neuere Modelle suchen mehr, und die denkenden suchen in mehr Runden und prüfen gefundene Zahlen nach – im CRM-Test brauchte das schnelle Modell 25 Suchanfragen, das denkende 45. Andere Messungen, die Lily Ray zusammenträgt, zeigen: ChatGPT ruft heute doppelt so viele Quellen ab wie vor einem Jahr und zitiert am Ende weniger Websites. Der Wettbewerb um jeden Platz wird härter.
Der Suchzettel-Test
Der Anker-Test prüft, ob ein Abschnitt zitiert werden kann. Der Suchzettel-Test prüft, ob er überhaupt gefunden wird.
Ob Deine Marke auf dem Suchzettel steht, ist messbar
Ein einzelner Suchzettel ist ein Würfelwurf. Surfer fand bei Google, dass nur etwa 27 % der Fan-out-Suchanfragen gleich bleiben, wenn dieselbe Frage mehrfach läuft. In meinen Tests empfahl ChatGPT auf die Rügen-Frage binnen Minuten zweimal dieselben zwei Hotels und ein drittes, das wechselte – einmal mit dem schnellen, einmal mit dem denkenden Modell. Belastbar wird das Bild erst, wenn dieselbe Frage viele Male an mehrere Modelle geht und Du zählst. Genau das ist die Verankerungsmessung. Und weil sich die Mechanik alle paar Wochen ändert, wird dieser Artikel nachgezogen – siehe Changelog.
Weiterlesen
Unverbindliches Erstgespräch
Wie stark ist Deine Marke in KI-Antworten verankert?
In ca. 15 Minuten zeige ich Dir die Messung und beantworte erste Fragen.